调研号称最快的快速傅里叶变换库fftw

调研主流开源fft c/c++库,最后选择了最为知名的fftw项目。 读完了官方最新版手册的大部分内容。和当前项目使用的简单实现做bechmarking,fftw的速度在我的测试环境中比简单实现快30~40倍。 测试环境: AMD 4G主频

44.1K采样10分钟 44.1K采样1分钟 44.1K采样10秒
简单实现 2.01017秒 0.203767秒 0.037936秒
fftw 0.047039秒 0.00466秒 0.001126秒
summary 42.3倍 43.7倍 33.7倍

帧长都是1024, 帧跳512。

虽然fftw的性能领先得非常地明显,但如果每一分钟左右,甚至更短的时间就计算一次,简单fft也能在一秒钟内完成。看来fft并非主要耗时部分。这次调研fft算法更新了我对fft的看法。我印象中FFT仅管是快速算法,仍然非常耗时,所以才需要DSP芯片。看来现在的通用CPU亦能应付大部分场景。

Linux下接链Matlab的库,它们在哪里~

这篇短博客就记一下matlab把库文件放哪~

64-bit Apple Mac 64-bit Linux
matlabroot/bin/maci64:matlabroot/sys/os/maci64 matlabroot/bin/glnxa64:matlabroot/sys/os/glnxa64

mac用的是名字是maci64, linux用的名字是glnxa64。
好奇怪的名字, glnxa ? 是不是 Gnu LiNuX Archives 的缩写呢?google了一会儿没找到答案。

用FFmpeg5.0 + SDL3 播放视频

上个月看完了讲H.264视频编解码的经典书:“The H.264 Advanced Video Compression Standard”,看完后感觉也不是那么难。记得大约十年前第一次看到预测(prediction), 运动补偿(motion compensation)之类的术语和示意图,感觉是非常晦涩难懂的知识。而现在补了基础信号理论的知识,也扫除了很多畏难心理。

后来了解到比较常用的开源H.264编码器是X264,而FFmpeg则自带一个广泛使用的开源H.264解码器。于是,我就想对照着开源代码,再过一遍理论知识。那就选FFmpeg吧~毕竟名气太大。

首先,得用FFmpeg整一个简单的播放器跑起来才能调试。但是,网络上虽然有大量FFmpeg编写简单播放器的代码,绝大部分代码却是无法用最新的FFmpeg通过编译的。毕竟FFmpeg在持续开发中,连上层API也会有变化。我下载了目前(2022/Feb/13)最新的代码,版本号是5.0。旧FFmpeg播放器代码跑不起来。

好在我在youtube.com上找到一位FFmpeg核心维护者Matt Szatmary做的presentation,An Introduction to Building tools with FFmpeg libraries and APIs – Matt Szatmary | August 2019,结合它的介绍,把简单的播放功能跑起来了。这里有个小遗憾没能找到Matt Szatmary的源代码,虽然他在视频中说是开源的。本来还想学习一下大佬的写法。

代码贴在这里。用这个小DEMO可以用调试器跟到FFmpeg的代码里看H264解码器的具体实现了。

#include <stdio.h>
#define __STDC_CONSTANT_MACROS
// Linux...
#ifdef __cplusplus
extern "C"
{
#endif
#include <libavcodec/avcodec.h>
#include <libavformat/avformat.h>
#include <libswscale/swscale.h>
#include <libavutil/imgutils.h>
#include <SDL2/SDL.h>
#ifdef __cplusplus
};
#endif

int sfp_refresh_thread(void *opaque);

// Refresh Event
#define SFM_REFRESH_EVENT (SDL_USEREVENT + 1)
#define SFM_BREAK_EVENT (SDL_USEREVENT + 2)
int thread_exit = 0;
int thread_pause = 0;

int sfp_refresh_thread(void *opaque)
{
    SDL_Event event;

    thread_exit = 0;
    thread_pause = 0;
    while (!thread_exit)
    {
        if (!thread_pause)
        {
            SDL_Event event;
            event.type = SFM_REFRESH_EVENT;
            SDL_PushEvent(&event);
        }
        SDL_Delay(40);
    }
    thread_exit = 0;
    thread_pause = 0;
    // Break
    event.type = SFM_BREAK_EVENT;
    SDL_PushEvent(&event);
    return 0;
}

int main(int argc, char *argv[])
{
    AVFormatContext *pFormatCtx;
    int i, videoindex;
    AVCodecParameters *pCodecPar;
    AVCodecContext *pCodecCtx;
    const AVCodec *pCodec;
    AVFrame *pFrame, *pFrameYUV;
    unsigned char *out_buffer;
    AVPacket *packet;
    int ret, got_picture;
    //------------SDL----------------
    int screen_w, screen_h;
    SDL_Window *screen;
    SDL_Renderer *sdlRenderer;
    SDL_Texture *sdlTexture;
    SDL_Rect sdlRect;
    SDL_Thread *video_tid;
    SDL_Event event;
    struct SwsContext *img_convert_ctx;
    char filepath[] = "video";

    // avformat_network_init();
    // pFormatCtx = avformat_alloc_context();
    pFormatCtx = NULL;    // MYNOTE: if pFormatCtx is not allocated explicitly using avformat_alloc_context()
    // pFormatCtx will be allocated implicitly in avformat_open_input.
    if (avformat_open_input(&pFormatCtx, filepath, NULL, NULL) != 0)
    {
        printf("Couldn't open input stream.\n");
        return -1;
    }
    if (avformat_find_stream_info(pFormatCtx, NULL) < 0)
    {
        printf("Couldn't find stream information.\n");
        return -1;
    }
    videoindex = -1;
    for (i = 0; i < pFormatCtx->nb_streams; i++)
        if (pFormatCtx->streams[i]->codecpar->codec_type == AVMEDIA_TYPE_VIDEO)
        {
            videoindex = i;
            pCodecPar = pFormatCtx->streams[i]->codecpar;
            break;
        }
    if (videoindex == -1)
    {
        printf("Didn't find a video stream.\n");
        return -1;
    }

    pCodec = avcodec_find_decoder(pCodecPar->codec_id);
    if (pCodec == NULL)
    {
        printf("Codec not found.\n");
        return -1;
    }
    pCodecCtx = avcodec_alloc_context3(pCodec);
    if (!pCodecCtx)
    {
        fprintf(stderr, "Could not allocate video codec context\n");
        exit(1);
    }
    // 这一步不能少,否则会崩溃。把CodecPar的参数再复制到codecCtx中
    ret = avcodec_parameters_to_context(pCodecCtx, pCodecPar);
    if (ret < 0)
    {
        printf("avcodec_parameters_to_context failed...");
        return -1;
    }
    // pCodecCtx = pFormatCtx->streams[videoindex]->codecpar;
    if (avcodec_open2(pCodecCtx, pCodec, NULL) < 0)
    {
        printf("Could not open codec.\n");
        return -1;
    }
    pFrame = av_frame_alloc();
    pFrameYUV = av_frame_alloc();
    size_t sz = av_image_get_buffer_size(AV_PIX_FMT_YUV420P, pCodecCtx->width, pCodecCtx->height, 1);
    out_buffer = (unsigned char *)av_malloc(sz);
    av_image_fill_arrays(pFrameYUV->data, pFrameYUV->linesize, out_buffer,
                         AV_PIX_FMT_YUV420P, pCodecCtx->width, pCodecCtx->height, 1);
    // Output Info-----------------------------
    printf("---------------- File Information ---------------\n");
    av_dump_format(pFormatCtx, 0, filepath, 0);
    printf("-------------------------------------------------\n");
    img_convert_ctx = sws_getContext(pCodecCtx->width, pCodecCtx->height, pCodecCtx->pix_fmt,
                                     pCodecCtx->width, pCodecCtx->height, AV_PIX_FMT_YUV420P,
                                     SWS_BICUBIC, NULL, NULL, NULL);
    if (SDL_Init(SDL_INIT_VIDEO | SDL_INIT_AUDIO |
                 SDL_INIT_TIMER))
    {
        printf("Could not initialize SDL - %s\n", SDL_GetError());
        return -1;
    }
    // SDL 2.0 Support for multiple windows
    screen_w = pCodecCtx->width;
    screen_h = pCodecCtx->height;
    screen = SDL_CreateWindow("Simplest ffmpeg player's Window",
                              SDL_WINDOWPOS_UNDEFINED,
                              SDL_WINDOWPOS_UNDEFINED,
                              screen_w, screen_h, SDL_WINDOW_OPENGL);
    if (!screen)
    {
        printf("SDL: could not create window - exiting:%s\n", SDL_GetError());
        return -1;
    }
    sdlRenderer = SDL_CreateRenderer(screen, -1, 0);
    // IYUV: Y + U + V (3 planes)
    // YV12: Y + V + U (3 planes)
    sdlTexture = SDL_CreateTexture(sdlRenderer,
                                   SDL_PIXELFORMAT_IYUV,
                                   SDL_TEXTUREACCESS_STREAMING, pCodecCtx->width, pCodecCtx->height);
    sdlRect.x = 0;
    sdlRect.y = 0;
    sdlRect.w = screen_w;
    sdlRect.h = screen_h;
    packet = (AVPacket *)av_malloc(sizeof(AVPacket));
    video_tid = SDL_CreateThread(sfp_refresh_thread, NULL, NULL);
    //------------SDL End------------
    // Event Loop
    for (;;)
    {
        char buf[1024];
        int ret;
        // Wait
        SDL_WaitEvent(&event);
        if (event.type == SFM_REFRESH_EVENT)
        {
            while (1)
            {
                if (av_read_frame(pFormatCtx, packet) < 0)
                    thread_exit = 1;
                if (packet->stream_index == videoindex)
                    break;
            }

            // ret = avcodec_decode_video2(pCodecCtx, pFrame, &got_picture, packet);
            // ret = my_decode();
            ret = avcodec_send_packet(pCodecCtx, packet);
            if (ret < 0)
            {
                fprintf(stderr, "Error sending a packet for decoding\n");
                exit(1);
            }

            while (ret >= 0)
            {
                ret = avcodec_receive_frame(pCodecCtx, pFrame);
                if (ret == AVERROR(EAGAIN))
                {
                    fprintf(stderr, "EAGAIN occurred...\n");
                    break;
                }
                if (ret == AVERROR_EOF)
                {
                    printf("byebye...\n");
                    exit(0);
                }
                if (ret < 0)
                {
                    fprintf(stderr, "Error during decoding\n");
                    exit(1);
                }

                printf("Got frame %3d\n", pCodecCtx->frame_number);
                fflush(stdout);

                /* the picture is allocated by the decoder. no need to
                   free it */
                // snprintf(buf, sizeof(buf), "%s-%d", "player.c", dec_ctx->frame_number);
                // pgm_save(frame->data[0], frame->linesize[0], frame->width, frame->height, buf);

                sws_scale(img_convert_ctx, (const unsigned char *const *)pFrame->data,
                          pFrame->linesize, 0, pCodecCtx->height, pFrameYUV->data, pFrameYUV->linesize);
                // SDL---------------------------
                SDL_UpdateTexture(sdlTexture, NULL, pFrameYUV->data[0],
                                  pFrameYUV->linesize[0]);
                SDL_RenderClear(sdlRenderer);
                SDL_RenderCopy(sdlRenderer, sdlTexture, NULL, NULL);
                SDL_RenderPresent(sdlRenderer);
                // SDL End-----------------------
            }

            // av_free_packet(packet);
            av_packet_unref(packet);
        }
        else if (event.type == SDL_KEYDOWN)
        {
            // Pause
            if (event.key.keysym.sym == SDLK_SPACE)
                thread_pause = !thread_pause;
        }
        else if (event.type == SDL_QUIT)
        {
            thread_exit = 1;
        }
        else if (event.type == SFM_BREAK_EVENT)
        {
            break;
        }
    }
    sws_freeContext(img_convert_ctx);
    SDL_Quit();
    av_frame_free(&pFrameYUV);
    av_frame_free(&pFrame);
    avcodec_free_context(&pCodecCtx);
    avcodec_close(pCodecCtx);
    avformat_close_input(&pFormatCtx);

    return 0;
}

adonisjs5的Ioc机制初探

什么是Ioc

Ioc(Inversion of Control)是一种设计模式.它指的是使用某对象/资源的代码,不负责该对象的依赖对象的创建和维护,而交给一个专门的容器来负责.这样,怎么创建对象的控制权就转移到了这个专门的容器,即实现了所谓的控制反转.Ioc用来降低对象之间由依赖关系产生的耦合.(按照软件工程理论,依赖算是最弱的一种耦合了.依赖 < 关联 < 聚合 < 组合< 继承)我感觉,Ioc算是一个升级版的工厂模式,它管理了大量的工厂函数和对应的资源名称.可以把创建资源/对象的依赖写在Ioc里面.

adonisjs5中的Ioc

我感觉有点奇怪,adonisjs5的官方文档中没有专门提及Ioc. https://docs.adonisjs.com/guides/introduction 但在adonisjs4.x https://legacy.adonisjs.com/docs/4.1/ioc-container 的官方文档中却有单独的一节来讲Ioc.以至于,我第一次读完adonis5的文档后,对Ioc竟然没什么印象.而Ioc却是adonis最为重要的概念.anyway~,看看adonis的源代码怎么处理Ioc吧.

注册Ioc

在adonisjs的代码中搜索一下,

find node_modules/@adonisjs -iname "*ioc*"

很容易发现adonisjs实现Ioc的代码在node_modules/@adonisjs/fold/build/src/Ioc/这个目录中.目录名就是Ioc,毫不掩饰自己的目的.
逛一逛Ioc这个目录下的js文件,发现最重要的是index.js 和 binBindings.js这两个文件.其中index.js中有一个类就叫Ioc, 而注册到Ioc中的资源被放在Bindings.js文件中Bindings类中.

    /**
     * Define a binding
     */
    register(binding, callback, singleton) {
        this.list.set(binding, { callback, singleton });
        return this;
    }

Binding类中的register函数非常显眼.显然注册一个资源到Ioc的代码会走到这里.在这里下断点,调起调试器.发现register函数的三个参数的含义是: binding即资源的的namespace,通过调试器发现注册的第一个资源的namespace是“Adonis/Core/Application”;callback相当于创建这种资源的工厂函数,调用它即生产出一个对应的对象;而singleton则是一个boolean值,指示该种资源是不是一个单件.看看栈的上一个frame,是Ioc类的singleton()函数.看来,“Adonis/Core/Application”这个资源是通过Ioc.singleton()创建的.

    /**
     * Same as the [[bind]] method, but registers a singleton only. Singleton's callback
     * is invoked only for the first time and then the cached value is used
     */
    singleton(binding, callback) {
        helpers_2.ensureIsFunction(callback, '"ioc.singleton" expect 2nd argument to be a function');
        this.bindings.register(binding, callback, true);
        return this;
    }

Ioc.singleton()函数注释告诉我们.single()函数跟bind()函数一样,只不过是注册一个单件,单件的callback工厂函数仅调用一次.第一次创建会把资源cache起来,而后直接返回cache.这个cache即Bindings类中的list成员.虽然名字是list,但却是一个Map.映射namespace到对象/资源.

    constructor(container) {
        this.container = container;
        /**
         * Registered bindings
         */
        this.list = new Map();   // 明明是个Map,为何叫list?misnomer~~
    }

在看Ioc.singleton()函数的注释时提到了它的friend, Ioc.bind()函数.于是,在Ioc.bind()中下断点看看.发现了’Adonis/Core/Helpers’的,会调到这里.Helpers竟然不是singleton,有点意外.Ioc.bind()同样会调用Bindings.register()把工厂函数存起来.

    /**
     * Register a binding with a callback. The callback return value will be
     * used when binding is resolved
     */
    bind(binding, callback) {
        helpers_2.ensureIsFunction(callback, '"ioc.bind" expect 2nd argument to be a function');
        this.bindings.register(binding, callback, false);
        return this;
    }

从Ioc创建对象/资源

最开始看adonisjs4的官方文档 ,提到从Ioc创建对象直接调用Ioc.use(‘namespace’).后来看到adnoisjs的作者(大佬HARMINDER VIRK)写的一篇博客 https://blog.adonisjs.com/introducing-adonisjs-v5/ 中讲他特希望把Ioc的use()干掉,改成用EM的import.但Virk大佬没说use()换成import有什么好处.其实在adonisjs5中,使用use()仍然是可以的。

If I ever wanted to improve something to AdonisJS, that was getting rid of the use method to import dependencies,
…
Finally, we have been able make ESM imports work with the AdonisJS IoC container. It means, you can import bindings from the container as follows:

import Route from '@ioc:Adonis/Core/Route'

大佬Virk还提到,用这种方式不能用alias,理由是IDE会帮你补全名称,所以使用长名字不是一个问题.

那么我们看看import是怎么让Ioc创建对象/资源的.在Bindings类的resolve()函数中下断点:

    /**
     * Resolve a binding. An exception is raised, if the binding is missing
     */
    resolve(binding) {
        const bindingNode = this.list.get(binding);
        if (!bindingNode) {
            throw IocLookupException_1.IocLookupException.lookupFailed(binding);
        }
        let resolvedValue;
        if (bindingNode.singleton) {
            bindingNode.cachedValue = bindingNode.cachedValue ?? bindingNode.callback(this.container);
            resolvedValue = bindingNode.cachedValue;
        }
        else {
            resolvedValue = bindingNode.callback(this.container);
        }
        return resolvedValue;
    }

这个函数根据namespace的名字创建对象.如果是单件,就返回cache中的原有对象;如果不是就创建一个返回.断点第一次命中是,resolve函数的binding参数是”adonis/Core/Env”.看来拦到了创建“donis/Core/Env”对象的代码.看栈的上一帧是Ioc.resolveBinding(),上上帧则是Ioc.use(),再往上就是import语句

import Env from '@ioc:Adonis/Core/Env'

这~~~import之后就直接到了Ioc.use()!!!魔法呀~~从栈的显示来看import语句被显示成<anonymous>.我猜import应该是被解析成一个特殊的无名函数,而有某种方法可以Hook这个无名函数,让import的时候,模块名前面五个字符是”@ioc:”时,就跳去Ioc.use().

不过,后来我搞懂了这个机制。adonisjs5自己整了一个Typescript的编译器。它提供了一个visitor模式可以访问typescript被编译成javascript的代码结构,并可以做修改。于是,用这个visitor模式可以把import Env from ‘@ioc:Adonis/Core/Env’ 替换成一个Ioc.use()调用,载入对象。这个Typescript编译器在这个工程中:https://github.com/adonisjs/require-ts

只写这么多吧.其实里面的内容还有很多~~
Fiduccia Mattheyses算法(即FM算法)的论文解读

kamuszhou的博客,转载请注明URL。

现代大规模集成电路图(VLSI)非常庞大,当我们希望用多个FPGA仿真一个VLSI时,需要把VLSI在满足一些约束条件的情况下切割成多个小部分,每个部分都可以装进一个FPGA。

这个问题抽象成数学模型,实际上就是一个超图分割的问题。在超图分割领域有一篇发表于1982年的论文,名字是”A Linear-Time Heuristic for Improving Network Partitions”。这篇论文提出了一种改进的“超图二分问题”算法,简称为FM算法。虽然在1982年这篇论文发表时,“超图分割”算法领域已经发展了近十年。但这篇论文似乎有着近乎祖师爷级论文的地位,相当多的后期该领域的论文都会引用这篇文章。论文发表之后该领域继续发展出的“层次化超图多分割”算法可以看成是FM算法发展而来。该算法中涉及到的概念和思路是后续算法的基础,是很好的该领域入门学习的资料。
(更多超图及超图分割的基础概念请自行搜索,本博客主要解读论文)

论文的下载地址:
https://ieeexplore.ieee.org/document/1585498

在论文的摘要部分论述到:本文提出了一种启发式的,利用最小割(mincut)的迭代算法解决超图二分问题。该算法在最坏情况下的时间复杂度也是线性的。在实际应用中,绝大多数情况下,该算法都只需要很少次数的迭代。算法有三个特点:
1. 超图被分成两个Block。每次移动一个结点把它从原来的Block移往另一个Block。同时维持两个Block的平衡。重要的是,这个平衡不是基于每个Block中的结点数量,而是更一般的size of block的概念,它考虑到了每个结点的权重是不一样的。
2. 利用一个相当高效的数据结构,可以在O(1)常数时间复杂度内找到需要移动的最佳结点。
3. 在移动了某个结点后,再高效地更新受上次移动影响的结点的信息(即论文后面会提到的结点的gain值)。这第三个特点亦在论文的Introduction中被再次提到,作者认为这是该论文的主要贡献(main contribution).

术语及基本概念

  • n(i): 当i是超边的编号时,n(i)定义为每个超边上的结点数目。
  • s(i)或p(i): 当i表示结点时,s(i)或p(i)表示结点上的PIN数目,即结点一共跟多个条超边有连接,更多时候亦称为结点的size。
  • 邻居结点: 如果两个结点至少能通过一条超边连接,即为邻居结点。
  • A,B: 代表超图二分割后的两个BLOCK。
  • |A|: |A| = \sum_{i=i}^{n}{s(i)} 即Block A的size定义为Block A中所有的结点的size的连加。
  • A(n)或B(n): n表示编号为n的边,A(n)则表示该条n在Block A中的结点数。
  • cut: 在A和B中都有结点的超边。
  • cutstate: 一条超边是不是cut(后来发展成多分割问题中的cutsize)。
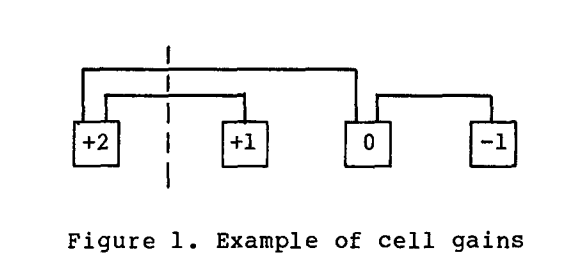
  • cell gains: 当移动一个结点到另一个BLOCK时,cut减少的数目。
    cell gains

维持平衡

最容易想到的是就是使超图二分割后的两个BLOCK中的结点数量大致相同。不过,可以稍微变复杂一点,即考虑每个结点的权重。
* W = |A| + |B| 所有结点的size连加和
* r = |A| / (|A| + |B|) 一个大小0到1之间的比率
* smax = \max_{1<i<n}{s(i)} 最大的结点size
* rW – k * smax <= |A| <= rW + k * smax;k > 1 平衡公式

公式不难,描述地很清楚。简单地讲,block的size考虑到了每个结点的权重不同。另外,允许每个block的size在满足比率r的附近上下浮动k个最大结点size。它的含义是,在刚好满足分割比率r的时候,还能够至少移动k个结点。

算法描述

  1. 随机找到一个划分A, B (初始划分并未严格要求是在平衡状态)
  2. 从A和B中都找出它们各自拥有最高gain值的结点,即有两个预备结点。
  3. 淘汰掉移动后会导致不平衡状态出现的预备结点。如果两个预备结点均被淘汰,则算法结束。
  4. 在这两个结点中选择拥有最高gain值的结点移动到对端。如果这两个预备结点gain值一样,就选会导致更好平衡状态的结点。如果还是一样,那就随你的心情挑一个(break ties as desired)。
  5. 锁定该结点,在本次迭代中不准再使用。
  6. 更新各个结点的gain值,跳到步骤2继续下一次迭代。

高效的数据结构

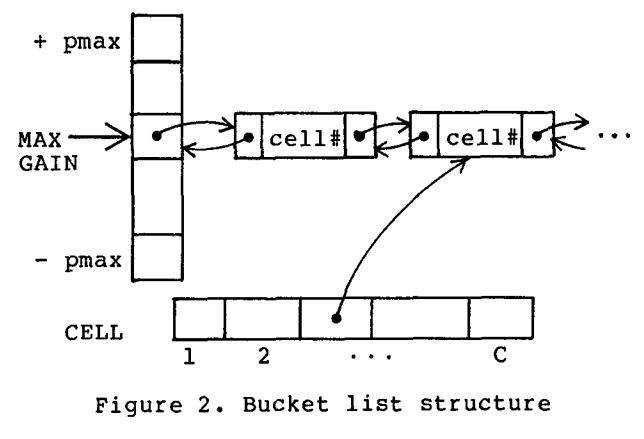
FM算法中有两个难点,即如何快速找到每个Block中gain值最高的结点以及高效的更新gain值以反应移动结点带来的变化。第一问题由下图所示的数据结构解决。
data structures

如图的数据结构共有两个。A,B两个BLOCK各有一个。其中 pmax即所有结点中最大size。显然,每个结点的gain值都在[-pmax, +pmax]之间。当pmax值相对较小时,可以用一个静态数组表示。FM论文中即用静态数组,但后来VLSI持续发展,静态数组太大的时候,即可换成用hash表。图中,坚着的数组表示在每一个gain值下面用链表存放Free结点,并用一个标记记录当前最高gain值是多少。横着的数组则存放了所有的结点。这样,就能在常数时间内找到最大的gain值和任意一个结点。

高效地更新gain值

当一个结点从当前BLOCK移到对端BLOCK后,会造成它的所有邻居结点的gain值有可能发生变化。如果用一个naive的算法,效率会很低。论文中论述了naive方法的时间复杂度O(P^2),P表示超图中所有PIN的总数目。这个时间复杂度很吓人,但我认为这是最坏极端情况下。但更详细的论述这里就略过吧,主要讲FM算法是怎么做的,这是该论文作者最得意的部分。

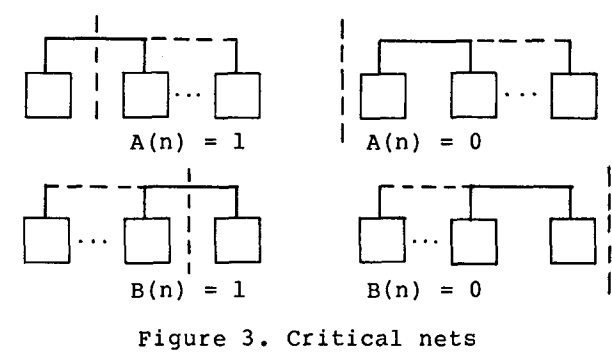
先引入关键边的概念。
critical net
当且仅当A(n)或B(n)等于0或者等于1时,一条边能称之为关键边。

(kamuszhou的博客,转载请注明源URL)

两个重要论述:

  1. If the net is not critical, its cutstate cannot be affected by a move

    如果一条边不是关键边,那么不可能只通过一次移动改变该边的cutstate。

  2. A net which is not critical either before or after a move cannot possibly influence the gains of any of its cells.

    如果一条边在移动前和移动后,它都不是关键边,那这条边则不影响gain值的更新。

那不就是~~~~
如何更新gain值,只用管移动前是关键边,或者移动后是关键边这两种情况么!!!

考察一个结点,把该结点从From Block移动到To Block这个移动前后的状态。
F(n)定义为一条超边n在From Block中的结点数。
T(n)定义为一条超边n在To Block中的结点数。
移动前符合哪些条件的边是超边呢?
F(n) = 1 or T(n) = 0 or T(n) = 1 其中F(n) = 0违反条件,不存在。
移动后哪些边是超边呢?
T(n) = 1 or F(n) = 0 or F(n) = 1 其中T(n) = 0违反条件,不存在。

再度惊人地发现!!!
移动前的F(n) = 1 即是移动后的 F(n) = 0
移动前的T(n) = 0 即是移动后的 T(n) = 1

于是~~符合什么条件的超边将影响gain值简化为:
移动前符合:
T(n) = 0 or T(n) = 1
移动后符合:
F(n) = 0 or F(n) = 1

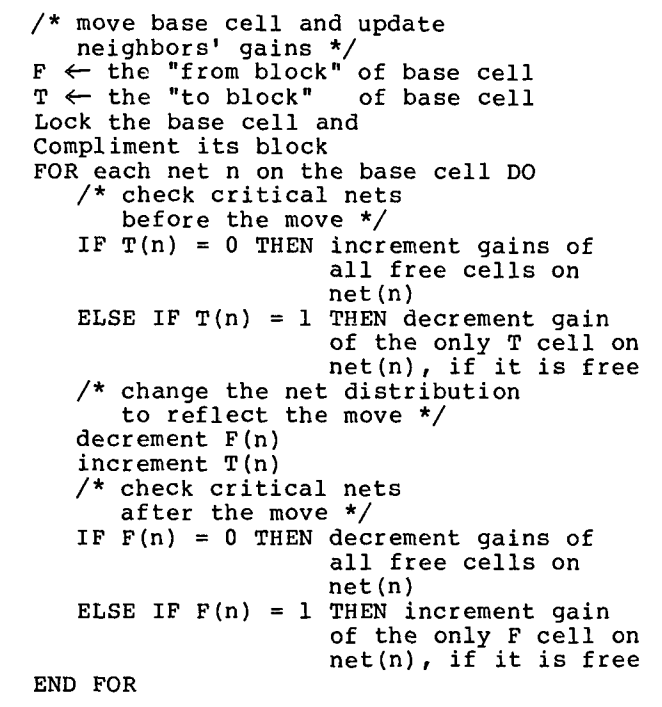
于是,得到算法:
udpate gains

本文未尽细节

本文省略了如何计算每个结点的初始gain值,和如何生成初始状态的数据结构。因为这两个算法都相对简单,所以就略过,着重于论文作者最为得意的高效更新gain值的部分。

Our main contribution consists of an analysis of the effects a cell move has on its neighboring cells and a subsequent efficient implementaion of these results.

本文还省略了论者发现的几个命题(proposition),及一些算法复杂度的分析和证明。

还省略了其他细节~最好还是读原文!给你不一样的丝滑感受。

FM算法的缺点

在另一篇论文中,提到FM算法的3个缺点。
1. 当两边Block选出的gain值一样时,给的处理方式过于简单,不够有洞察力(insightful)。
2. 当一条超边在两个Block中的结点数都大于或等于两个时,它们就没有资格在第一时间被选为待移动结点。这显然太过greedy了。
3. 好像还提到过其他缺点但是我忘记了~

读后感

为何大佬那么厉害~
一个结点的移动对它的邻居结点gain值的影响的分析确实相当之精彩。虽然没有复杂的数学公式,但同样逻辑严谨,抽丝剥茧的分析。让人拍案叫绝~
为何作者能思考得这么有条理和深入??
除了具体的算法本身,还能学到哪些思考分析复杂问题的方式呢?
1. 简化问题
2. 提炼规律

转载请注明出处。

如何知道gcc/g++ 的默认C++版本

C++在C++ 11之后在保持向后兼容的情况下,语法增强了非常多,变化很大。得益于Move语义,和一些标准库的改进(如std::list的size()函数在C++11之前是O(n)的复杂度,从C++11开始变成常数复杂度)。一些旧C++代码即使什么改动也不做,只需要在新的C++标准下编译,也能获得性能提升。一般要给g++开启C++11需要用 -std=c++11,开启C++17则是 -std=c++17。那么,如果不添加这些选项,gcc/g++默认使用的C++版本号是什么呢?

如果你的gcc/g++版本号大于4.7的话,可以用如下命令获得默认c++版本。

kamus@shyyp.net:~g++ --version | head -1
g++ (Ubuntu 9.3.0-17ubuntu1~20.04) 9.3.0
kamus@shyyp.net:~ g++ -dM -E -x c++  /dev/null | grep -F __cplusplus
#define __cplusplus 201402L
kamus@shyyp.net:~$ gcc -dM -E -x c++  /dev/null | grep -F __cplusplus    #其实用gcc也可以
#define __cplusplus 201402L

如上所示,我的g++版本是9.3.0。它的默认C++版本是C++14。
这是我家用的电脑。我在公司的机器上运行结果如下:

kamuszhou@centos ~ g++ --version | head -1
g++ (Ubuntu 4.8.4-2ubuntu1~14.04.3) 4.8.4
kamuszhou@centos~ g++ -dM -E -x c++  /dev/null | grep -F __cplusplus
#define __cplusplus 199711L

如上所示,老版的g++ 4.8.4用的默认C++版本还是c++98

再解释一下这里用到的gcc/g++的选项, 这里-dM的意思是:

Instead of the normal output, generate a list of ‘#define’ directives for all the macros defined during the execution of the preprocessor, including predefined macros. This gives you a way of finding out what is predefined in your version of the preprocessor.

对所有宏,包括预定义的宏,在预编译阶段输出一系列的#define。

-E的意思是,做完预编译后即退出,不执行真正的编译。
-x c++表示使用C++语言。

安卓平台下面开发DSP应用

这两天考察在手机上面写DSP应用的可能性,找了一些资料读了,有这些困难:

安卓平台:
谷歌有一个叫Oboe的C++库帮助开发音频APP,但是官方文档只提供了一些简单的例子,没有给出类似效果器之类有复杂数学运算的例子。我担心很多DSP运算的实时性得不到保证。

得有DSP芯片的配合才能写出高效的DSP算法,虽然 arm CPU集成有DSP芯片,但是要充分利用DSP的指令,得用arm的付费编译器,据说挺贵的。而且,如果用DSP的指令优化算法,

安卓碎片化的问题有更多的坑。如果用了非常底层的代码(直接写死了DSP的指令),代码在不同的机器上可能表现很不一样,很可能有些机器跑不起来。

一篇2014年的技术文章 https://www.androidauthority.com/state-audio-android-414978/ 讲在android平台下面开发DSP的应用很困难。虽然是7年前的文章,但也很有参考价值。

苹果iOS:
苹果对DSP有很好的支持,但是我没有Mac电脑也没有iphone手机,没办法做开发。

不过,有一个superepowered的开源库,声称完美提供了开发DSP的能力。但是这个库不是完全免费的。官网上也没有明确价格,需要Contact sales。 https://superpowered.com/pricing
那算了,没太大兴趣了解。

用琴生(Jensen)不等式证明期望最大值(EM)算法收敛

今年二月份刷了一遍“机器学习白板推导”系列视频。https://www.bilibili.com/video/BV1aE411o7qd 。这个机器学习的公式推导系列讲地真是太好了,当时像追剧一般花了两个星期听完。非常感谢录这个视频系列的老师shuhuai008。不过,因为以前机器学习的基础几乎为0,又没有动手做相关练习。三个半月以后,又忘了很多了。昨天,我想起要复习一下EM算法,于是又把视频捡起来找到EM算法的部分,复习一下。

第二次看,果然快了很多。不过,在用琴生不等式证明EM算法收敛的部分,卡住了。我不断回忆第一次看的时候是如何理解的,奈何回忆不起来了。于是,找到Jensen不等式的词条看了看,琢磨了好久。终于懂了,在这里把这个思考过程记下来。

我卡在这个步骤:需要用Jensen Inequality证明如下不等式:

上面公式中的z表示模型中的隐变量,x表示观测值,\theta是参数,\theta^{(t)}表示theta在第t时刻的值(EM算法是一个迭代算法)。

证明这个不等式需要用到琴生不等式在凹函数上的性质。如下:
设f(x)中一个凹函数(凹函数图形和中文字凹的形状相反,可以理解为上凸,log函数即一个凹函数),下面的不等式成立。
a_1f(x_1) + a_2f(x_2) + \dots + a_nf(x_n) \le f(a_1x_1 + a_2x_2 + \dots + a_nx_n)
且 a_1 + a_2 + \dots + a_n = 1

用自然语言描述是:凹函数定义域内的n个自变量对应的因变量的线性组合小于或等于n个自变量先做线性组合再求对应的因变量,作线性组合的系数之和为1。简单地说:先求函数值再做线性组合 小于或等于 先做线性组合再求函数值。

再回到我们要证明的不等式。积分号即可看成是无穷多个值的线性组合,对数符号log后面对应的那一坨
{\frac{P(z|x, \theta^{(t+1)})} {P(z|x, \theta^{(t)})} }
看成是log函数的因变量,log前面的
P(z|x, \theta^{(t)})
看成是线性组合的系数,很明显这个系数是满足积分和为1的概率密度。于是,就可以套用上面提到的凹函数上的琴生不等式。不等式的右边为0,左边是“先求函数值再做线性组合”,化简为左边小于“先做线性组合再求函数值”:
\begin{aligned}
左边 &\le log_{}{\int\limits_z {\frac{P(z|x, \theta^{(t+1)})} {P(z|x, \theta^{(t)})} } P(z|x, \theta^{(t)})}dz \&=log_{}{}\int \limits_zP(z|x,\theta^{(t+1)})dz=log_{}{1}=0
\end{aligned}

得证!

使用tailwindcss创建一个全屏模式对话框

最开始用的css UI库是最常用,历史最悠久的bootstrap。 后来又接触了bulma,bulma也做得很漂亮,不过我没有把bulma用在实战中。前段时间打算改版我的粤语网站https://ykyi.net, 调研了多种技术方案,最终选中了nextjs。读nextjs官方文档时发现tailwind是nextjs默认配好的css库。这是第一次接触到tailwindcss。较之Bulma和bootstrap这些UI库给了开箱即用的很多控件,tailwind只是提供了很多css工具(css类),用户需要用这些工具自己创建最终使用的控件。一开始会让人有点畏惧,实际使用之后,其实完全自己创建美观的UI控件也并非有那么困难。

今天用tailwind做了一个全屏的模式对话框Modal Dialog。代码实际上是从网上抄下来的。天下代码我抄你,你抄我嘛~~
HTML代码如下。

<div className="bg-gray-200 flex items-center justify-center h-screen">
    <button className="modal-open btn btn-green">Open Modal</button>

  <div className="modal opacity-0 pointer-events-none fixed w-full h-full top-0 left-0 flex items-center justify-center">
    <div className="modal-overlay absolute w-full h-full bg-gray-900 opacity-50"></div>

    <div className="modal-container bg-white w-11/12 md:max-w-md mx-auto rounded shadow-lg z-50 overflow-y-auto">
      <div className="modal-content py-4 text-left px-6">
        <div className="flex justify-between items-center pb-3">
          <p className="text-2xl font-bold">Simple Modal!</p>
          <div className="modal-close cursor-pointer z-50">
            <svg className="fill-current text-black" xmlns="http://www.w3.org/2000/svg" width="18" height="18" viewBox="0 0 18 18">
              <path d="M14.53 4.53l-1.06-1.06L9 7.94 4.53 3.47 3.47 4.53 7.94 9l-4.47 4.47 1.06 1.06L9 10.06l4.47 4.47 1.06-1.06L10.06 9z"></path>
            </svg>
          </div>
        </div>

        <p>Modal content can go here</p>
        <p>...</p>
        <p>...</p>
        <p>...</p>
        <p>...</p>

        <div className="flex justify-end pt-2">
          <button className="btn btn-green m-2">Action</button>
          <button className="modal-close btn btn-green m-2">Close</button>
        </div>

      </div>
    </div>
  </div>

对应的Javascript代码如下:

var openmodal = document.querySelectorAll('.modal-open')
for (var i = 0; i < openmodal.length; i++) {
openmodal[i].addEventListener('click', function(event){
event.preventDefault()
toggleModal()
})
}

var overlay = document.querySelector('.modal-overlay')
overlay.addEventListener('click', toggleModal)

var closemodal = document.querySelectorAll('.modal-close')
for (var i = 0; i < closemodal.length; i++) {
closemodal[i].addEventListener('click', toggleModal)
}

document.onkeydown = function(evt) {
evt = evt || window.event
var isEscape = false
if ("key" in evt) {
isEscape = (evt.key === "Escape" || evt.key === "Esc")
} else {
isEscape = (evt.keyCode === 27)
}
if (isEscape && document.body.classList.contains('modal-active')) {
toggleModal()
}
};


function toggleModal () {
const body = document.querySelector('body')
const modal = document.querySelector('.modal')
modal.classList.toggle('opacity-0')
modal.classList.toggle('pointer-events-none')
body.classList.toggle('modal-active')
}

让我有点吃惊的时,模式对话框并非使用display:hide达到隐藏的效果。而是使用opacity:0(tailwind的opacity-0类),即不使用模式对话框时,模式对话框在一个全透明的div里面,达到隐藏的效果。当需要展示的时候,删除opacity-0类,即完全不透明,此时模式对话框就展示出来了。

Tailwind这个css工具库还是不错!多用了几次以后,我觉得可以抛弃bootstrap了。想要一个什么UI控件的时候,用tailwind加控件名搜索一下,已经有网友贡献了现成的代码。拿过来理解以后,更方便定制。

讲讲为什么要用javascript的requestAnimationFrame函数在web上实现复杂动画效果

简单地讲,requestAnimationFrame函数更适合在浏览器上面做复杂的动画。比用定时器效率高。

废话如下:

现代的WEB世界(2020年),网页上各种各样的内容丰富多彩。虽然css也能完成很多简单的动画,但是仍然有一些复杂的动画animation需求需要javascript处理。之前,我简单地理解,浏览器已经有定时器函数setTimeout()和setInterval(),就足够做出复杂的动画形式。原来,不是这样的。

这段时间在做一个运行在浏览器上的红白机模拟器,参考开源代码,发现用的是requestAnimationFrame()函数。于是,查了一些资料,涨了知识。

首先,使用定时器SetTimeout和setInterval做动画有两个大缺点。

  1. 受有限的资源,或者糟糕的cpu密集的业务代码的影响。浏览器并不严格按照定时器函数中的时间间隔参数来调度定时回调函数。比如50ms,有时会快,有时会慢。这样,动画效果的帧与帧之间的画面就不会那么流畅了。
  2. 频繁的调用计时器函数setTimeout或setInterval,可能导致浏览器假死。浏览器竭尽全力的处理一些跟动画无关的代码,比如文档流的不断重排。这样,用户的界面根本没有获得重新渲染的机会。特别在手机浏览器,由于手机的环境比较特殊。手机的电池可以不够,网络不好,都可能影响web页面的文档重排(page reflow)的效率。

为什么用requestAnimationFrame

  1. 针对定时器的缺点1,浏览器的实现保证requestAnimationFrame设定的回调函数会严格定时执行。当然是在web页是活跃状态,即不是在后台运行。等下会讲到后台执行时的情况。一般浏览器调用requestAnimationFrame设定的回调函数的频率是每秒60次。不同浏览器的实现有不变。

  2. 当web页面被放入后台运行时,浏览器会大辐降低requestAnimationFrame设置的回调函数调用频率。低至每秒两次,甚至暂停。这样,又能节省相当多的资源。比如手机上珍贵的电池资源。非常容易理解,web页面不可见的时候,还继续渲染画面是完全没有意义的。

需要注意的地方

既然requestAnimationFrame的调用频率因浏览器而异,另外页面在后台时又可能会暂停。所以,生成动画的代码不能预设回调函数以某一个固定的频率执行。解决这个问题,requestAnimationFrame的回调函数会传入一个时间戳参数,

下面是官方文档对传入回调函数的时间参数的解释,给了一个高精度的时间戳,单位是毫秒。嗯,对于浏览器来说,如果能精确到毫秒的话,算得上高精度的时间戳了。

The callback function is passed one single argument, a DOMHighResTimeStamp similar to the one returned by performance.now(), indicating the point in time when requestAnimationFrame() starts to execute callback functions